41139021
با ما در تماس باشید


سیستم مورد نیاز برای اجرای هوش مصنوعی لوکال را نمیتوان فقط با عبارتهایی مثل «کارت گرافیک قوی» یا «رم بالا» مشخص کرد. در اجرای محلی مدلهای زبانی بزرگ، نخست باید بدانید مدل چند پارامتر دارد، وزنها با چه دقتی ذخیره شدهاند، طول Context چقدر است، چند کاربر همزمان از مدل استفاده میکنند و هدف فقط گفتوگو و استنتاج است یا Fine-tuning نیز انجام میشود. ممکن است یک مدل کمحجم روی سیستم معمولی باز شود، اما پاسخگویی آنقدر کند باشد که استفاده روزانه عملاً توجیه نداشته باشد.
این راهنما برای انتخاب و خرید کامپیوتر یا ورکاستیشن اجرای محلی LLM نوشته شده است؛ یعنی سیستمهایی که ابزارهایی مانند Ollama، LM Studio، llama.cpp یا رابطهای متصل به آنها را اجرا میکنند. تمرکز مقاله روی ارتباط اندازه مدل با VRAM، نقش Quantization، تفاوت GPU و RAM، محدودیت چند کارت گرافیک و طراحی یک مسیر ارتقای منطقی است. برای آشنایی عمومیتر با سختافزار آموزش مدل و تولید تصویر، صفحه راهنمای خرید سیستم هوش مصنوعی مسیر کاملتری دارد.

برای شروع جدی، معیار اصلی معمولاً ظرفیت حافظه قابل استفاده است، نه صرفاً توان خام GPU. مدلهای کوچک Quantized را میتوان با ۸ تا ۱۲ گیگابایت VRAM اجرا کرد. برای مدلهای متوسط و Context بلند، ۱۶ تا ۲۴ گیگابایت انعطاف بسیار بیشتری میدهد. مدلهای بزرگتر ممکن است به ۳۲، ۴۸ یا بیش از ۴۸ گیگابایت حافظه نیاز داشته باشند و در این نقطه انتخاب میان GPU حرفهای، چند GPU یا حافظه یکپارچه مطرح میشود. این اعداد سقف قطعی نیستند؛ Runtime، معماری مدل، Cache، تعداد درخواستها و روش Offload نتیجه را تغییر میدهند.
| نوع استفاده | ظرفیت GPU عملی | RAM پیشنهادی | نکته تعیینکننده |
|---|---|---|---|
| آزمایش مدلهای کوچک و چت شخصی | ۸ تا ۱۲ گیگابایت VRAM | ۳۲ گیگابایت | مدل Quantized و Context کنترلشده |
| استفاده روزانه، کدنویسی و RAG سبک | ۱۶ تا ۲۴ گیگابایت VRAM | ۶۴ گیگابایت | جای کافی برای وزنها و KV Cache |
| مدلهای متوسط، Context بلند یا چند سرویس | ۲۴ تا ۴۸ گیگابایت VRAM | ۶۴ تا ۱۲۸ گیگابایت | سربار Runtime و همزمانی کاربران |
| مدلهای بزرگ و Fine-tuning تخصصی | بیش از ۴۸ گیگابایت یا چند GPU | ۱۲۸ گیگابایت یا بیشتر | پلتفرم، خطوط PCIe، پاور و خنککاری |
عددهایی مانند 7B، 14B یا 70B تعداد تقریبی پارامترهای مدل را نشان میدهند، اما مستقیماً برابر حافظه مصرفی نیستند. هر پارامتر بسته به دقت وزنها میتواند تقریباً دو بایت در FP16، یک بایت در 8-bit یا حدود نیم بایت در 4-bit فضا بگیرد. بنابراین یک تخمین ابتدایی برای خود وزنها از ضرب تعداد پارامتر در اندازه هر پارامتر به دست میآید. این محاسبه هنوز KV Cache، بافرهای محاسباتی، لایههای Runtime و حافظه سیستمعامل را حساب نکرده است.
به همین دلیل جمله «مدل ۳۰ میلیاردپارامتری روی کارت ۲۴ گیگابایتی اجرا میشود» فقط با ذکر نسخه Quantized و شرایط اجرا قابل دفاع است. انویدیا در راهنمای Multi-GPU خود برای نمونه، مدل ۳۰B چهار بیتی را در محدوده ۲۴ گیگابایت و مدل 70B را در محدوده بیش از ۴۰ گیگابایت قرار میدهد؛ اما Context بلند، Batch بالاتر یا معماری متفاوت میتواند مصرف واقعی را افزایش دهد. فایل مدل و گزارش حافظه Runtime مرجع نهاییاند، نه نام تجاری مدل.
Quantization وزنهای مدل را با دقت عددی پایینتری ذخیره میکند تا حافظه و پهنای باند کمتری مصرف شود. فرمتهای 4-bit معمولاً امکان اجرای مدلی را میدهند که نسخه FP16 آن در GPU جا نمیشود. در مقابل، کاهش دقت میتواند بسته به روش Quantization، نوع مدل و وظیفه روی کیفیت پاسخ اثر بگذارد. Q4، Q5 و Q8 فقط «کیفیت کم، متوسط و زیاد» نیستند؛ پیادهسازی و نوع Quantization نیز اهمیت دارد.
برای چت، خلاصهسازی، کدنویسی روزمره و RAG، نسخه Quantized مناسب اغلب انتخاب منطقیتری از خرید سختافزار صرفاً برای بارگذاری FP16 است. اما برای ارزیابی علمی، Fine-tuning حساس، پردازش دستهای یا کاربردی که افت کیفیت کوچک هم هزینهساز است، باید دقت بالاتر و حافظه بیشتر را بررسی کرد.
طول Context تعداد توکنهایی است که مدل میتواند در یک درخواست نگه دارد؛ برای مثال متن گفتگو، اسناد RAG و پاسخ در حال تولید. افزایش Context حافظه KV Cache را بالا میبرد و این مصرف میتواند در مدلهای بزرگ و استفاده همزمان قابل توجه شود. ادعای اجرای یک مدل با Context کوتاه را نباید به اجرای همان مدل با چند سند بلند یا چند کاربر تعمیم داد.
اگر وزنها و Cache داخل VRAM قرار بگیرند و Runtime از شتابدهی GPU پشتیبانی کند، GPU معمولاً بیشترین اثر را بر سرعت تولید توکن دارد. ظرفیت VRAM تعیین میکند چه مقدار از مدل روی GPU میماند و پهنای باند حافظه در بسیاری از بارهای استنتاجی بر سرعت اثر مستقیم دارد. توان محاسباتی نیز مهم است، اما مقایسه فقط بر اساس تعداد هسته CUDA یا نام نسل کافی نیست.
CPU همچنان مدل را بارگذاری میکند، Tokenization، مدیریت سیستم و بخشی از Offload را انجام میدهد. برای یک سیستم تکGPU، پردازنده میانرده جدید غالباً کافی است و انتقال بودجه از VRAM به پردازنده گرانتر نتیجه ضعیفتری میدهد. در چند GPU، تعداد خطوط PCIe، چیدمان اسلاتها و توان پلتفرم مهمتر میشود. پردازنده قویتر زمانی توجیه دارد که همزمان Data Preparation، فشردهسازی، پایگاه برداری، چند سرویس یا بارهای CPUمحور نیز اجرا شوند.
بله. ابزارهایی مانند llama.cpp میتوانند بخشی یا تمام مدل را روی RAM و CPU اجرا کنند یا تعدادی از لایهها را به GPU بسپارند. مزیت این روش دسترسی به ظرفیت بسیار بیشتر با هزینه پایینتر از VRAM است. ضعف آن سرعت پایینتر و وابستگی شدیدتر به پهنای باند حافظه سیستم است. بازشدن مدل به معنی مناسببودن تجربه استفاده نیست؛ باید زمان اولین توکن، سرعت تولید توکن و تأخیر در Context واقعی سنجیده شود.
برای سیستم تکGPU، بهتر است RAM حداقل دو برابر حجم فایل مدل و متناسب با برنامههای همزمان انتخاب شود. این یک قانون تضمینی نیست، اما برای بارگذاری، Cache سیستمعامل و Offload حاشیه امن میسازد. در استفاده حرفهای ۶۴ گیگابایت نقطه شروع منطقیتری از ۳۲ گیگابایت است؛ برای مدلهای بزرگ، RAG حجیم یا چند سرویس، ۱۲۸ گیگابایت و بیشتر قابل توجیه میشود.
چند GPU بیش از هر چیز ظرفیت حافظه مجموع را افزایش میدهد، اما حافظه کارتها بهصورت خودکار به یک استخر یکپارچه تبدیل نمیشود. Runtime باید مدل را میان کارتها تقسیم کند و انتقال داده، سرعت کارت کندتر و توپولوژی PCIe میتوانند روی عملکرد اثر بگذارند. دو کارت متفاوت ممکن است برای آزمایش قابل استفاده باشند، اما برای یک ورکاستیشن پایدار، کارتهای همرده و پلتفرم طراحیشده برای چند GPU انتخاب قابل پیشبینیتری هستند.
برای بررسی عملی محدودیتها، مقاله استفاده از دو کارت گرافیک در ComfyUI تفاوت «داشتن دو GPU» با «استفاده واقعی نرمافزار از هر دو» را توضیح میدهد. همین اصل در LLM نیز برقرار است: پشتیبانی نرمافزار باید پیش از خرید تأیید شود.
سیستمهای زیر نقطه شروع مقایسهاند. انتخاب نهایی باید با فایل مدل، تعداد کاربران، ظرفیت VRAM، نیاز به چند GPU و مسیر ارتقا تطبیق داده شود.


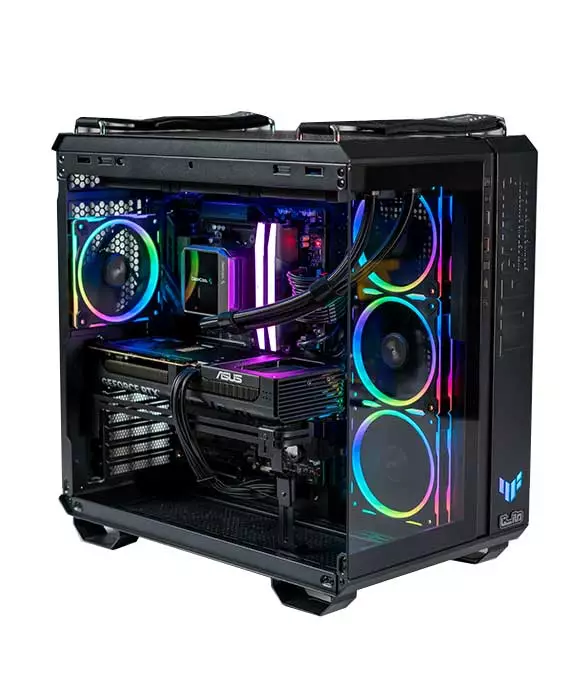


ابتدا بزرگترین مدلی را که واقعاً استفاده میکنید با Quantization هدف انتخاب کنید. سپس حجم فایل، Context مورد نیاز و سربار Runtime را به ظرفیت حافظه اضافه کنید. خرید GPU صرفاً بر اساس رتبه گیمینگ خطاست؛ کارت سریعتر با VRAM کمتر ممکن است مدل هدف را کامل در حافظه نگه ندارد. برای مقایسه دقیقتر نسلها و ظرفیتها، راهنمای انتخاب کارت گرافیک برای هوش مصنوعی محلی را ببینید.
RAM باید مدل، برنامههای جانبی، پایگاه برداری و Offload احتمالی را پوشش دهد. چهار ماژول پرظرفیت ممکن است دستیابی به فرکانس بالای حافظه را دشوارتر کند؛ بنابراین ظرفیت، پایداری و امکان ارتقا مهمتر از اعداد تبلیغاتی فرکانس هستند. برای سیستم ۶۴ یا ۱۲۸ گیگابایتی بهتر است چینش ماژولها و فهرست سازگاری مادربرد بررسی شود.
مدلها، نسخههای Quantized و دیتاستها بهسرعت فضای زیادی مصرف میکنند. NVMe ظرفیت مناسب، بارگذاری و جابهجایی مدل را سریعتر میکند، اما پس از قرارگرفتن کامل مدل در حافظه، SSD معمولاً تعیینکننده سرعت تولید توکن نیست. تقسیم سیستمعامل و ابزارها از کتابخانه مدلها، مدیریت Backup و ارتقا را سادهتر میکند. ظرفیت ۲ ترابایت برای شروع حرفهای معقول است، ولی آرشیو چند مدل بزرگ یا داده Fine-tuning میتواند به فضای بیشتری نیاز داشته باشد.
استنتاج طولانی میتواند GPU را برای ساعتها زیر بار نگه دارد. توان نامی پاور بهتنهایی کافی نیست؛ کیفیت منبع تغذیه، کانکتور مناسب، حاشیه توان و مسیر کابل اهمیت دارند. در سیستم چند GPU باید فضای فیزیکی، هوای ورودی مستقل و دفع گرمای تجمعی بررسی شود. مادربرد مصرفی که دو اسلات دارد الزاماً برای دو کارت ضخیم و بار مداوم مناسب نیست.
اصل نیاز حافظه از خود مدل میآید، اما Runtime در پشتیبانی GPU، نوع Quantization، Offload، مدیریت Context و سرعت متفاوت است. Ollama راهاندازی و سرویسدهی را ساده میکند. LM Studio رابط گرافیکی مناسبی برای دریافت و آزمایش مدلها دارد. llama.cpp کنترل فنی بیشتری روی فرمت GGUF و Offload ارائه میدهد و موتور اجرای بسیاری از ابزارهای دیگر نیز هست. نتیجه یک مدل را فقط وقتی مقایسه کنید که فایل، Quantization، Context، تعداد Thread و تعداد لایههای GPU یکسان باشند.
Inference یعنی استفاده از مدل آماده برای تولید پاسخ. Fine-tuning وزنها یا آداپترهایی مانند LoRA را با داده جدید تنظیم میکند و معمولاً حافظه و زمان بیشتری میخواهد. Training از صفر به منابع بسیار بزرگتری نیاز دارد و برای اغلب کاربران ورکاستیشن شخصی هدف واقعبینانهای نیست. خرید سیستمی که برای چت محلی مناسب است، تضمین نمیکند همان مدل روی آن Fine-tune شود.
برای Fine-tuning باید Batch Size، طول Sequence، Optimizer، دقت محاسبات، Gradient Checkpointing و روش LoRA یا QLoRA مشخص شود. اگر هدف هنوز روشن نیست، طراحی سیستم با VRAM بیشتر، RAM قابل ارتقا و پاور مناسب از خرید CPU گرانتر و پلتفرم بسته ارزشمندتر است.
| کلاس | کاربرد واقعی | اولویت هزینه | محدودیت اصلی |
|---|---|---|---|
| شروع و آزمایش | مدل کوچک Quantized، چت و کدنویسی شخصی | GPU با ۱۲ تا ۱۶ گیگابایت، RAM قابل ارتقا | مدلهای بزرگ و Context بلند |
| حرفهای تکGPU | مدلهای متوسط، RAG، توسعه نرمافزار و تولید محتوا | GPU با ۲۴ تا ۳۲ گیگابایت، ۶۴ تا ۱۲۸ گیگابایت RAM | مدلهایی که از ظرفیت یک کارت عبور میکنند |
| ورکاستیشن چند GPU | مدل بزرگ، چند سرویس یا Fine-tuning تخصصی | ظرفیت مجموع VRAM، پلتفرم PCIe، پاور و خنککاری | هزینه، گرما و وابستگی به پشتیبانی Runtime |
این کلاسها عمداً به مدل کارت مشخصی قفل نشدهاند؛ موجودی بازار و نسل محصولات تغییر میکند، اما معیار انتخاب ثابت میماند. در زمان خرید باید ظرفیت واقعی VRAM، پشتیبانی Runtime، توان مصرفی و قیمت همان روز بررسی شود.
برای بسیاری از مدلهای کوچک و Quantized و استفاده شخصی کافی است، اما برای مدلهای متوسط، Context بلند و Fine-tuning محدودیت جدی ایجاد میکند. نام مدل و فایل دقیق باید معیار باشد.
ابتدا ظرفیت لازم برای جاگرفتن مدل و Cache را تأمین کنید؛ سپس سرعت را مقایسه کنید. GPU سریعتر که مدل هدف را کامل نگه نمیدارد ممکن است در استفاده واقعی از کارت کندتر اما پرحافظهتر نتیجه ضعیفتری بدهد.
خیر. فقط در صورتی میتوان ظرفیت مجموع را برای یک مدل به کار گرفت که Runtime مدل را میان دو کارت تقسیم کند. هزینه انتقال داده، توپولوژی PCIe و سرعت هر کارت نیز باقی میماند.
برای آزمایش، استفاده کمتعداد یا مدلی که در VRAM جا نمیشود میتواند منطقی باشد. برای پاسخگویی سریع و استفاده مداوم، GPU سازگار معمولاً تجربه بهتری ارائه میدهد.
به تعداد و اندازه مدلها بستگی دارد. برای استفاده حرفهای، ۲ ترابایت نقطه شروع عملی است؛ کتابخانه چند مدل، دیتاست و نسخههای Quantized میتواند ظرفیت بیشتری مصرف کند.
در خرید سیستم اجرای هوش مصنوعی لوکال، ترتیب درست تصمیمگیری این است: مدل و کاربرد، Quantization، Context، ظرفیت حافظه، Runtime و سپس سرعت. VRAM نخستین فیلتر است؛ GPU، پهنای باند حافظه و Runtime سرعت را تعیین میکنند؛ RAM و SSD امکان Offload و مدیریت مدلها را میسازند؛ مادربرد، پاور و خنککاری نیز مسیر ارتقای ایمن را مشخص میکنند. هیچ پیکربندی واحدی برای Ollama، LM Studio، RAG، Fine-tuning و سرویس چندکاربره بهترین نیست.
نام مدل، Quantization، طول Context، تعداد کاربران، هدف Inference یا Fine-tuning و بودجه را ارسال کنید تا پیکربندی بر اساس بار واقعی و مسیر ارتقا انتخاب شود.


